Gemini 4 Argon, Google mostra otto applicazioni del ragionamento avanzato tra software, documenti e progettazione 3D
Read Time:9 Minute, 55 Second
Un archivio di oltre 80.000 file della NASA trasformato in una presentazione, fotografie di una scrivania utilizzate per costruire un ambiente tridimensionale giocabile e un motore grafico capace di simulare il movimento del pelo di un personaggio. Sono alcune delle applicazioni che Google ha documentato il 27 ottobre 2026 per mostrare le capacità di Gemini 4 Argon, il modello di intelligenza artificiale progettato per affrontare attività complesse attraverso ragionamento prolungato, programmazione e utilizzo coordinato di strumenti digitali.
L’approfondimento, pubblicato sul blog ufficiale dell’azienda con otto esempi applicativi, arriva dopo la presentazione del modello avvenuta a settembre e la successiva estensione dell’accesso agli abbonati Google AI Pro e Ultra. L’attenzione si sposta così dalle caratteristiche tecniche alle operazioni che il sistema può effettivamente eseguire.
Il modello Gemini 4 Argon viene impiegato in attività che richiedono di interpretare materiali eterogenei, sviluppare codice e coordinare applicazioni esterne. I risultati mostrati da Google riguardano soprattutto prototipi e dimostrazioni realizzate in ambienti controllati. Non costituiscono, da soli, una prova che qualsiasi utente possa ottenere gli stessi risultati con identiche istruzioni, tempi e risorse.
Dagli archivi della NASA a una presentazione strutturata
Uno degli esempi più significativi riguarda l’elaborazione di una raccolta di dati provenienti dalle missioni NASA su Marte. Google ha fornito a Gemini 4 Argon un modello personalizzato di presentazione e un insieme di oltre 80.000 file contenenti registrazioni meteorologiche, informazioni ingegneristiche, dati scientifici e sanitari raccolti durante 72 voli.
L’attività è stata eseguita attraverso Google Antigravity, l’ambiente di sviluppo che permette di utilizzare agenti di intelligenza artificiale per organizzare ed eseguire operazioni articolate.
Il sistema ha analizzato i materiali, organizzato le informazioni e prodotto una presentazione destinata a un pubblico dirigenziale, con contenuti strutturati e rappresentazioni visive.
Il caso evidenzia un’applicazione concreta del ragionamento avanzato: ricavare un documento utilizzabile da una quantità elevata di informazioni inizialmente non organizzate per quello scopo.
L’operazione comprende diversi passaggi. Occorre interpretare file di natura differente, individuare informazioni rilevanti, stabilire collegamenti tra i dati e adattare il risultato a una struttura comunicativa prestabilita. La generazione delle slide costituisce soltanto l’ultima fase.
La dimostrazione non documenta però un controllo indipendente dell’accuratezza di ogni informazione inserita nella presentazione. Non sono inoltre pubblicati, nell’approfondimento, dati sufficienti per confrontare sistematicamente tempi di elaborazione, errori e interventi umani con quelli richiesti da un gruppo di analisti.
Il vantaggio potenziale riguarda la preparazione di una prima versione organizzata del materiale. Per documenti scientifici, tecnici o destinati a decisioni aziendali rimane necessario verificare la corrispondenza tra i risultati prodotti e le fonti originali.
Documenti complessi e contenuti scientifici diventano animazioni
Un secondo esempio riguarda la trasformazione di capitoli accademici in contenuti audiovisivi. Partendo da un documento PDF contenente concetti scientifici, Gemini 4 Argon ha utilizzato gli strumenti Nano Banana e Veo per produrre un’animazione illustrata dei passaggi principali.
La particolarità dell’esperimento risiede nella combinazione di attività differenti. Il modello deve comprendere il contenuto del documento, selezionare le informazioni da rappresentare e predisporre istruzioni compatibili con gli strumenti dedicati alla produzione visiva.
L’elaborazione del documento e la generazione delle immagini restano operazioni distinte, anche quando vengono coordinate attraverso una sola interfaccia.
Questa differenza è rilevante soprattutto per l’utilizzo in ambito formativo e professionale. Un’animazione può rendere più accessibile un argomento difficile, ma la correttezza scientifica delle rappresentazioni deve essere valutata separatamente dalla qualità estetica.
Il modello Gemini 4 Argon può quindi contribuire alla preparazione di materiali didattici e divulgativi, senza che questo equivalga a una validazione automatica dei contenuti prodotti.
Nelle specifiche tecniche pubblicate da Google, il sistema supporta l’acquisizione di testo, immagini, video, audio e PDF, mentre l’output diretto del modello è testuale. La produzione di contenuti audiovisivi descritta negli esempi dipende dall’integrazione con altri strumenti.
Cinquemila righe di codice per una biblioteca tridimensionale
La programmazione occupa una parte consistente delle dimostrazioni. In uno degli esperimenti, Gemini 4 Argon ha ricevuto una breve istruzione per costruire una biblioteca tridimensionale illuminata dalla luce solare.
Secondo la documentazione pubblicata il 27 ottobre, il sistema ha sviluppato circa 5.000 righe di codice matematico per realizzare la scena, senza partire da risorse grafiche o librerie già predisposte. Ha successivamente prodotto anche un video relativo al processo.
L’esempio permette di comprendere perché Google attribuisca particolare importanza alle capacità di ragionamento prolungato. La costruzione di un ambiente tridimensionale comporta la definizione della geometria, il posizionamento degli oggetti, la gestione della prospettiva e il calcolo degli effetti luminosi.
Si tratta di operazioni collegate: modificare un elemento della scena può richiedere aggiornamenti ad altre parti del programma.
La quantità di codice generato, tuttavia, non rappresenta una misura sufficiente della qualità del software. Per giudicare il risultato servirebbero ulteriori informazioni sulla manutenzione del codice, sulla stabilità dell’applicazione, sulle prestazioni e sulla possibilità di modificarla successivamente.
Google mostra anche la realizzazione di un’applicazione capace di sovrapporre elementi grafici a un video. Il sistema traccia linee musicali che seguono i movimenti rilevati nelle immagini; il movimento attiva note sonore, generando una composizione audiovisiva dinamica.
In questo caso l’interesse tecnico riguarda l’integrazione tra analisi visiva, programmazione e produzione sonora. Il risultato richiede che i dati ricavati dai fotogrammi vengano convertiti in eventi utilizzabili dall’applicazione.
Fotografie reali trasformate in ambienti interattivi
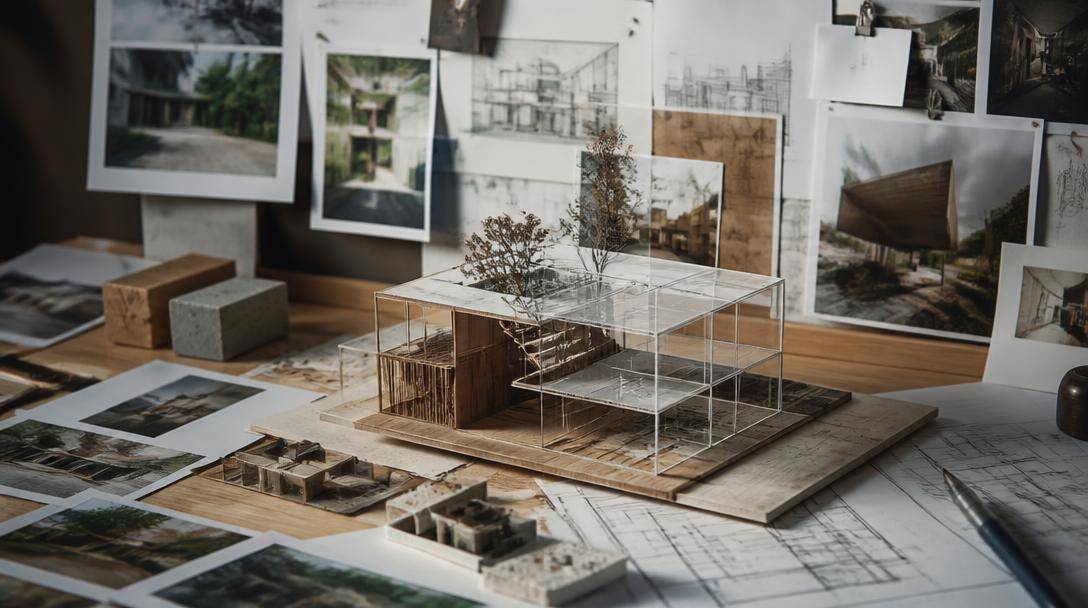
La progettazione tridimensionale viene affrontata anche attraverso un esperimento condotto partendo dalle fotografie di una scrivania.
Utilizzando Gemini 4 Argon in Antigravity, Google ha coordinato diversi componenti, tra cui sottoagenti software, Blender MCP e Nano Banana, per ricostruire lo spazio fotografato e trasformarlo in un percorso 3D giocabile.
Il riferimento a Blender MCP è significativo. MCP, acronimo di Model Context Protocol, permette di collegare un sistema di intelligenza artificiale a strumenti esterni attraverso interfacce strutturate. Nel caso descritto, il modello può coordinare operazioni effettuate da software specializzati nella realizzazione di contenuti tridimensionali.
Il procedimento non equivale alla semplice generazione di un’immagine. L’ambiente finale deve possedere caratteristiche spaziali e interattive che permettano di utilizzarlo come scenario di gioco.
Il modello Gemini 4 Argon assume quindi un ruolo di coordinamento tra interpretazione delle fotografie, definizione della scena e sviluppo delle componenti necessarie all’interazione.
L’applicazione può interessare la prototipazione di videogiochi, la progettazione di spazi virtuali e la preparazione di dimostrazioni interattive. L’esperimento non dimostra però che il sistema sia in grado di ricostruire automaticamente qualsiasi ambiente reale con precisione metrica.
Simulazioni fisiche, animazioni e sincronizzazione audio
Altri esempi presentati da Google riguardano la generazione di effetti grafici complessi.
Attraverso Antigravity, Gemini 4 Argon ha sviluppato un motore personalizzato per simulare il pelo di un personaggio tridimensionale, con dinamiche capaci di adattarsi ai movimenti.
Una simulazione di questo tipo richiede di gestire numerosi elementi grafici e le loro variazioni durante l’animazione. La qualità dipende da fattori quali illuminazione, movimento, comportamento delle superfici e risorse computazionali disponibili.
Google ha inoltre presentato una lettera G interattiva che combina simulazione dei fluidi e suoni reattivi, oltre a una tavola periodica tridimensionale navigabile autonomamente, con atomi animati e audio sincronizzato.
Quest’ultimo esperimento è stato costruito utilizzando come riferimento musicale The Elements di Tom Lehrer. Il modello ha coordinato la rappresentazione degli elementi chimici con la successione temporale dell’audio.
Gli esempi indicano la possibilità di automatizzare una parte delle attività normalmente distribuite tra programmazione, animazione e sincronizzazione multimediale.
Resta da distinguere la riuscita di una dimostrazione specifica dall’affidabilità in un processo produttivo continuativo. Per adottare strumenti simili nello sviluppo professionale occorre verificare se i risultati siano modificabili, riproducibili e compatibili con i requisiti del progetto.
Come funziona il ragionamento avanzato di Gemini 4 Argon
Le capacità mostrate da Google dipendono da alcune caratteristiche tecniche del modello.
Gemini 4 Argon dispone di una finestra contestuale unificata di 1.048.576 token, utilizzabile per gestire una quantità particolarmente ampia di informazioni. La documentazione prevede inoltre tre livelli configurabili di ragionamento, denominati low, medium e high.
Il livello intermedio costituisce l’impostazione predefinita nell’API. Le configurazioni permettono di adattare l’elaborazione alla complessità dell’attività, con possibili conseguenze sui tempi di risposta e sul consumo di risorse.
Una capacità importante riguarda la generazione di output estesi. La modalità sincrona predefinita prevede un massimo di 65.536 token in uscita, mentre la funzione di generazione prolungata può arrivare fino a 1.048.576 token, utilizzando una modalità di esecuzione specifica.
Per operazioni particolarmente lunghe, Google raccomanda l’esecuzione in background e l’adeguamento dei tempi di attesa dei client.
Queste caratteristiche risultano pertinenti allo sviluppo software e ai processi che richiedono numerose operazioni successive. Un agente incaricato di analizzare documenti, scrivere codice, utilizzare strumenti e rivedere il risultato deve conservare una quantità considerevole di informazioni durante l’elaborazione.
La disponibilità di una finestra contestuale ampia non garantisce comunque che ogni dettaglio venga interpretato correttamente. Anche la capacità di produrre codice molto lungo non elimina la necessità di test, revisioni e controlli.
Disponibilità del modello, abbonamenti e limiti di accesso
Il modello Gemini 4 Argon è disponibile attraverso diversi canali, ma le condizioni cambiano in base all’utilizzo.
Gli sviluppatori possono accedere al modello tramite Gemini API e Google AI Studio. Le imprese possono utilizzarlo anche attraverso gli strumenti della piattaforma Gemini e le soluzioni professionali previste da Google.
Per gli utenti individuali, l’accesso nell’app Gemini e nella modalità AI della Ricerca Google è previsto per gli abbonati Google AI Pro e Ultra. Gli stessi piani consentono l’utilizzo del modello in Google Antigravity, secondo le condizioni e i limiti applicabili.
L’accesso a Gemini 4 Argon tramite API non è disponibile nel livello gratuito.
La documentazione per sviluppatori indica inoltre un prezzo introduttivo valido fino al 30 novembre 2026, pari a 2 dollari per milione di token in ingresso e 10 dollari per milione di token in uscita, compresi quelli utilizzati nel ragionamento.
Dal 1° dicembre 2026 sono previsti prezzi di 4 dollari per milione di token in ingresso e 20 dollari per milione di token in uscita. Sono contemplate condizioni differenti per alcune modalità di utilizzo e per i contenuti gestiti attraverso la cache.
Il costo di un’applicazione complessa può dipendere anche dal numero di elaborazioni effettuate, dagli strumenti collegati e dalle eventuali interrogazioni ai servizi esterni.
Nelle specifiche tecniche figurano il supporto all’esecuzione di codice, alle chiamate di funzione, agli output strutturati e all’integrazione con Google Search e Maps. L’utilizzo del computer è indicato come funzionalità in anteprima.
Non risultano invece supportate direttamente dal modello la generazione di immagini, la generazione audio e la Live API. Le applicazioni audiovisive mostrate nell’approfondimento utilizzano quindi componenti aggiuntivi, che possono avere requisiti e disponibilità differenti.
Il valore delle dimostrazioni e ciò che resta da verificare
Le otto applicazioni pubblicate il 27 ottobre offrono indicazioni sul tipo di attività che Google intende affidare ai sistemi di ragionamento avanzato.
La preparazione di una presentazione da migliaia di documenti, la realizzazione di strumenti interattivi e lo sviluppo di simulazioni tridimensionali condividono una caratteristica: il risultato richiede una sequenza di decisioni tecniche e operative, anziché una singola risposta testuale.
Il modello Gemini 4 Argon viene utilizzato per coordinare tali operazioni, mentre software e servizi specializzati eseguono alcune delle attività necessarie.
La distinzione tra modello e strumenti collegati permette anche di evitare equivoci con Genie 4, il sistema Google DeepMind dedicato alla generazione e alla simulazione interattiva di ambienti virtuali. I due progetti affrontano problemi differenti, benché possano essere entrambi associati alla produzione di esperienze tridimensionali.
Per valutare l’efficacia delle nuove applicazioni servono prove che vadano oltre gli esempi selezionati: ripetizione dei test, analisi degli errori, misurazione delle risorse utilizzate e confronto con procedure alternative.
Nel caso degli archivi NASA, per esempio, il passaggio decisivo sarebbe verificare quanto fedelmente la presentazione riproduca le informazioni originali. Nello sviluppo software occorrerebbe invece misurare la qualità del codice generato e la sua capacità di funzionare in condizioni differenti da quelle della dimostrazione.
La disponibilità attraverso API rende possibili queste verifiche anche al di fuori degli esperimenti pubblicati da Google. Per le aziende interessate a integrare il sistema nei propri processi, il primo dato da misurare sarà la quota di lavoro effettivamente completata senza correzioni, insieme al costo delle elaborazioni e agli interventi necessari per rendere utilizzabile il risultato.


Happy
0 %

Sad
0 %

Excited
0 %

Sleepy
0 %

Angry
0 %

Surprise
0 %
 0
 0